PDF 엑셀 변환기
PDF 엑셀 변환, 다시 입력할 필요 없이: 이 페이지는 PDF 안의 표를 찾아 스프레드시트 셀로 다시 만들어 줍니다. 모든 처리는 내 기기에서 이루어지므로 파일이 어디로도 전송되지 않습니다.
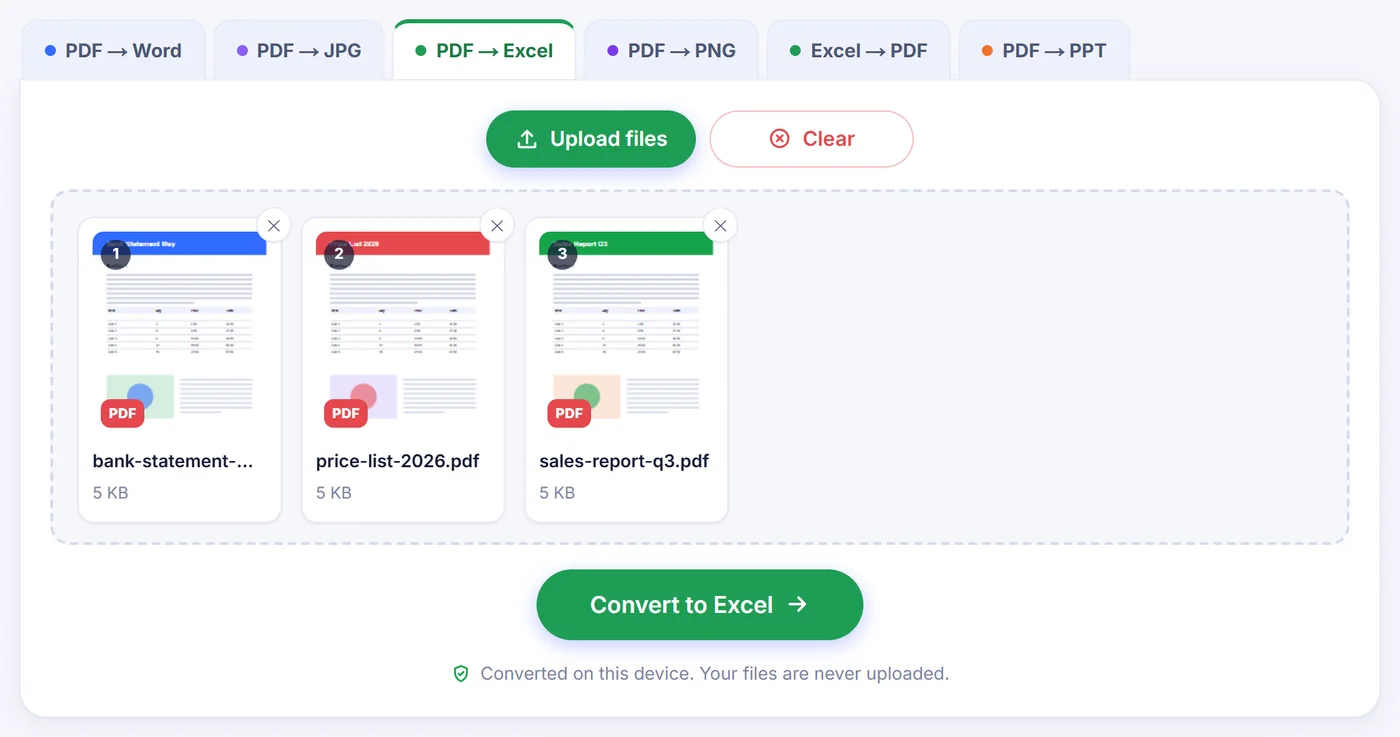
변환은 이 기기에서 이루어집니다. 파일은 어디에도 업로드되지 않습니다.
사용 방법
PDF를 끌어다 놓기
거래내역서, 청구서, 보고서 하나만 넣어도 되고, PDF를 한 번에 최대 20개까지 추가할 수도 있습니다.
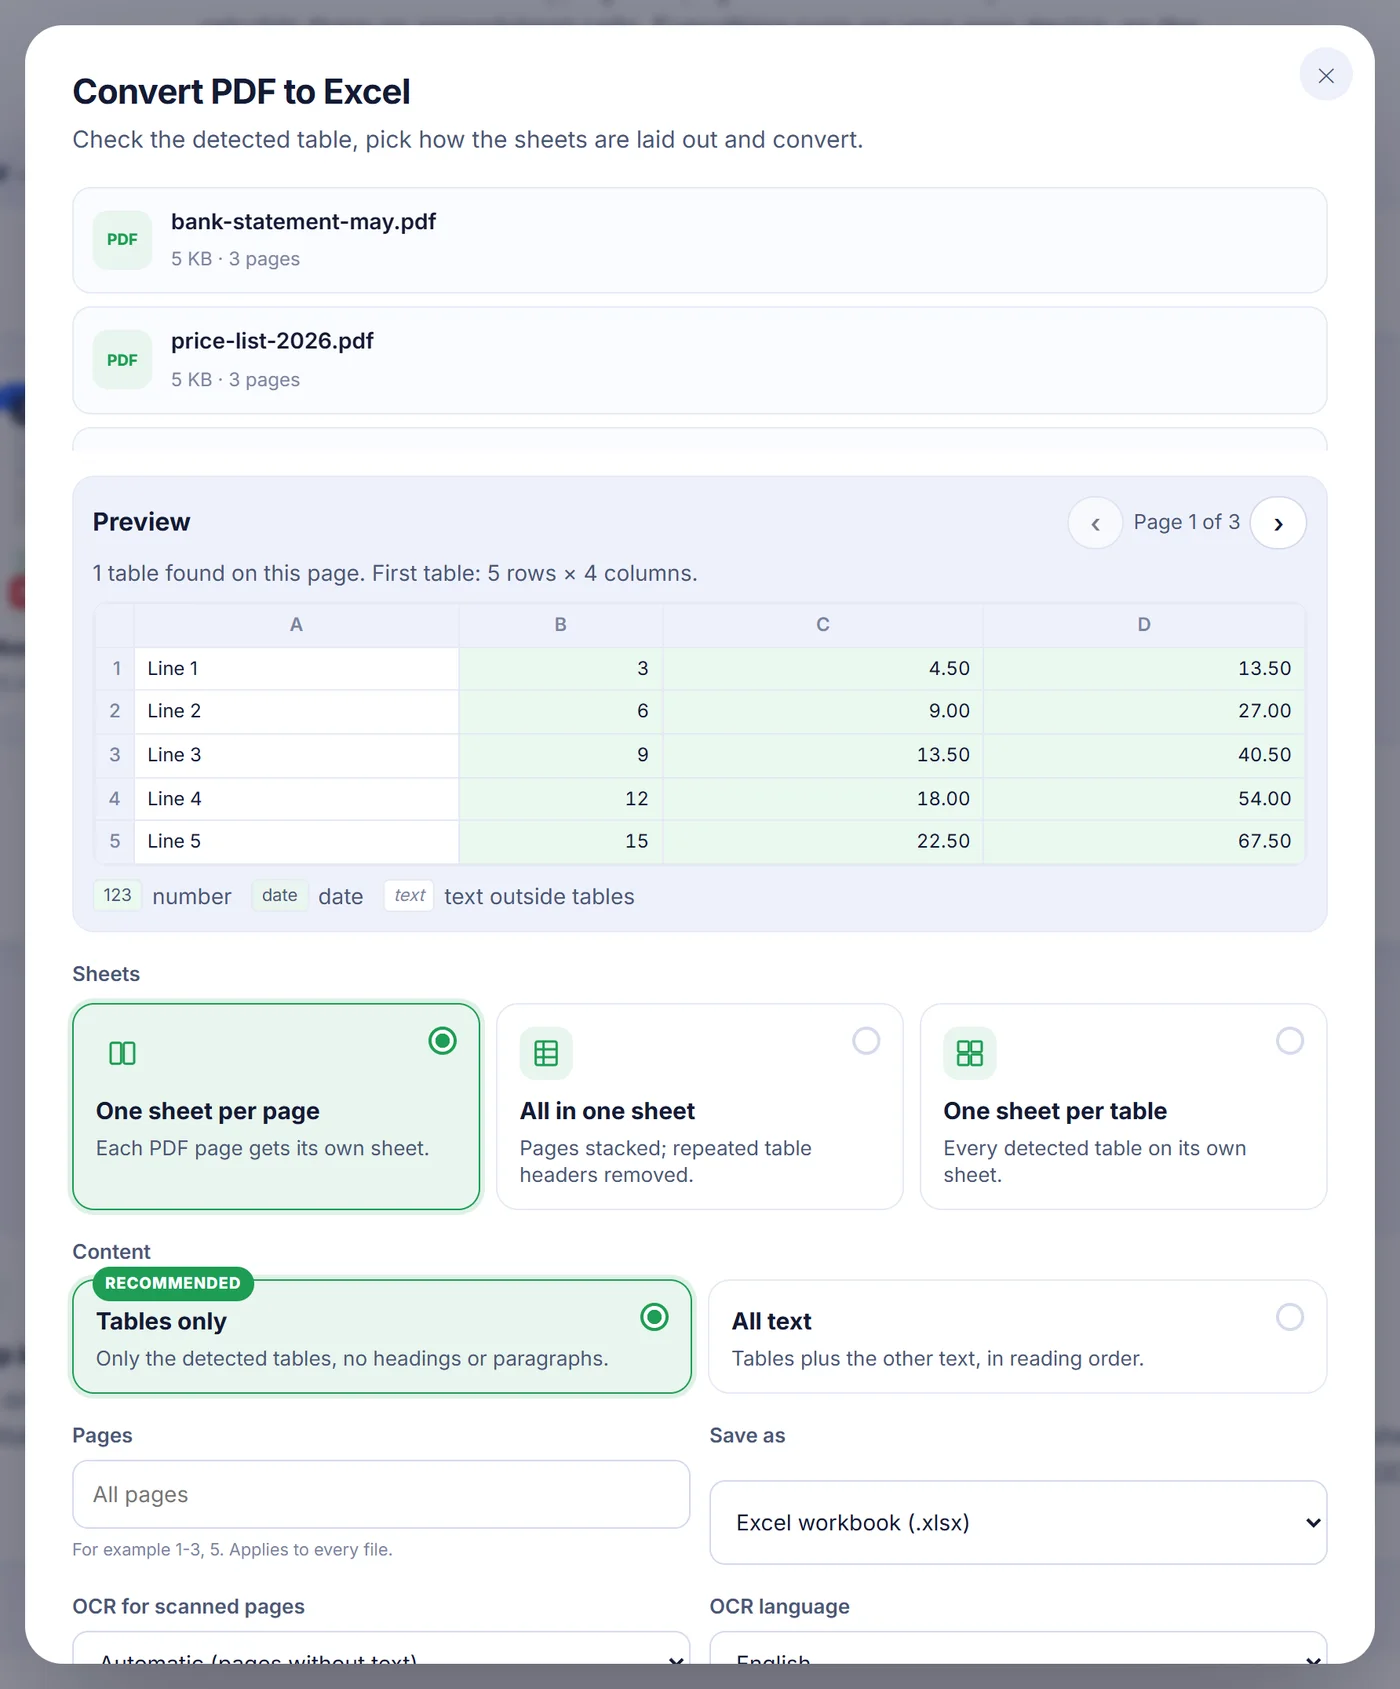
미리보기 확인
작은 격자에 페이지에서 찾은 표가 표시되고, 확정하기 전에 숫자와 날짜가 강조되어 보입니다.
배치 선택 후 저장
페이지마다 시트 하나, 모두 한 시트에, 표마다 시트 하나 중에서 고르고 XLSX, ODS 또는 CSV로 다운로드하세요.
PDF를 엑셀로 옮기는 일이 생각보다 어려운 이유
PDF는 표가 무엇인지 전혀 알지 못합니다. 작은 텍스트 조각들과 각 조각이 페이지의 어느 위치에 그려지는지만 저장할 뿐입니다. PDF에서 가격표를 복사해 워크시트에 붙여 넣으면 대개 긴 한 열로 늘어지거나, 한 행 전체가 셀 하나에 뭉쳐 들어갑니다. 30쪽짜리 은행 거래내역서를 손으로 바로잡으려면 오후 한나절이 그대로 사라집니다.
이 변환기는 그 텍스트 위치를 읽어 거꾸로 되짚어 갑니다. 같은 기준선 위에 놓인 단어들은 하나의 행이 됩니다. 단어 사이의 넓은 간격은 행을 여러 조각으로 나눕니다. 그런 다음 여러 행을 한꺼번에 살펴 텍스트가 반복해서 나타나는 세로 띠를 찾아내고, 그 띠가 열이 됩니다. 각 조각의 전체 너비를 사용하기 때문에 왼쪽 맞춤된 이름, 오른쪽 맞춤된 금액, 가운데 맞춤된 코드가 모두 올바른 열에 들어갑니다.
이 페이지에서 PDF를 엑셀로 변환하는 방법
- 파일을 추가합니다. 페이지로 끌어다 놓거나 탭해서 선택하세요. PDF가 잠겨 있으면 비밀번호를 묻는데, 이 비밀번호는 문서를 여는 데에만 브라우저 안에서 사용됩니다.
- 미리보기를 확인합니다. 옵션 창에 첫 번째 파일이 페이지 단위로 표시되며, 화살표로 페이지를 넘길 수 있습니다. 격자 위의 한 줄에 표가 몇 개 발견되었는지, 첫 번째 표가 몇 행 몇 열인지 나옵니다. 숫자, 날짜, 일반 텍스트가 색으로 구분되어 잘못 읽힌 열을 한눈에 찾을 수 있습니다.
- 시트 배치를 선택합니다. “One sheet per page”(페이지마다 시트 하나)는 원본의 페이지 구분을 그대로 유지합니다. “All in one sheet”(모두 한 시트에)는 모든 페이지를 앞 페이지 아래에 차례로 쌓고, 첫 번째 표 머리글과 글자 하나까지 똑같은 뒤쪽 표 머리글은 제거합니다. 긴 거래 목록에 딱 맞는 방식입니다. “One sheet per table”(표마다 시트 하나)는 감지된 표마다 별도의 탭을 만들고, 표 번호와 페이지로 이름을 붙입니다.
- 표만, 또는 모든 텍스트. 권장 설정인 “Tables only”(표만)는 표만 남깁니다. 제목, 주소, 메모까지 표 사이에 읽는 순서대로 넣고 싶다면 “All text”(모든 텍스트)로 바꾸세요.
- 필요하면 페이지를 제한합니다. Pages(페이지) 입력란에 2-6, 9처럼 입력하세요. 4-처럼 끝을 비워 두면 마지막 페이지까지 포함됩니다.
- 출력 형식을 고르고 변환 버튼을 누르세요. XLSX는 Excel에서 바로 열리고, ODS는 LibreOffice 등 OpenDocument 앱에 적합하며, CSV는 시트마다 일반 텍스트 파일 하나를 만듭니다.
숫자가 진짜 숫자로 동작합니다
숫자처럼 보이기만 하는 텍스트로 가득한 스프레드시트는 쓸모가 별로 없습니다. SUM은 0을 돌려주고 정렬은 사전순으로 됩니다. 여기서는 금액이 알맞은 셀 서식을 가진 실제 숫자 값으로 바뀝니다. 천 단위 구분 기호, 숫자 앞뒤의 통화 기호나 통화 코드(예: $, €, £, EUR, lei), 백분율, 마이너스 기호, 괄호로 음수를 나타내는 회계식 표기까지 모두 이해합니다. 2025-03-14, 14.03.2025, Mar 14, 2025 같은 흔한 형태의 날짜는 월별로 필터링할 수 있는 진짜 Excel 날짜가 됩니다.
또한 문서가 1,234.56 방식인지 1.234,56 방식인지, 03/04가 4월 3일인지 3월 4일인지도 파일의 다른 곳에서 모호하지 않은 예를 찾아 추측합니다. 추측이 틀렸다면 고급 설정을 열어 소수점 구분 기호와 날짜 순서를 직접 지정하세요. 숫자 변환을 완전히 끄는 것도 가능하며, 그러면 모든 셀이 PDF에 인쇄된 텍스트 그대로 유지됩니다. 카드 번호처럼 15자리를 넘는 숫자열과 00417처럼 0으로 시작하는 코드는 반올림되거나 잘리는 일이 없도록 의도적으로 텍스트로 남겨 둡니다.
옮겨지는 것과 옮겨지지 않는 것
- 유지됨: 셀 텍스트, 행과 열 구조, 여러 열에 걸친 셀(병합된 셀로 기록), 두세 줄로 줄바꿈된 표 셀(다시 한 셀로 합쳐짐). 열 너비는 가장 긴 값에 맞춰집니다.
- 유지되지 않음: 글꼴, 색상, 테두리, 음영, 로고, 그림, 차트. 결과물은 페이지 디자인의 복사본이 아니라 깔끔한 데이터 격자입니다.
- 건너뜀: 여백을 따라 세로로 쓰인 라벨처럼 옆으로 인쇄된 텍스트. 미리보기에서 이런 항목이 몇 개 제외되었는지 알려 줍니다. 페이지 전체가 가로 방향으로 놓인 경우는 처리되며, 텍스트가 실제로 흐르는 방향으로 읽습니다.
파일 전체에 표가 하나도 없으면 대신 텍스트를 행 단위로 내보내고, 결과 창에 그 사실이 표시됩니다. 일부 페이지에만 표가 있다면 “All text”를 선택해 다른 페이지가 비어 있지 않도록 하세요.
스캔한 PDF와 표를 찍은 사진
스캔은 그림일 뿐이므로 읽을 텍스트가 없습니다. 페이지에 텍스트가 거의 없으면 변환기가 해당 페이지에 대해 자동으로 문자 인식을 켭니다. 페이지를 약 200 dpi로 렌더링하고, 인식된 단어는 일반 PDF와 같은 표 감지 과정을 거칩니다. OCR 언어는 영어, 독일어, 프랑스어, 스페인어, 루마니아어, 폴란드어, 러시아어, 그리스어 등 20개 중에서 고를 수 있고, 내장 텍스트 레이어가 엉망이라면 모든 페이지에 OCR을 강제로 적용할 수도 있습니다.
언어 데이터(약 2~10 MB)는 처음 사용할 때 한 번 다운로드되므로, 첫 실행 시에는 인터넷 연결이 필요합니다. 인식은 일반 PDF를 읽는 것보다 느리며, 똑바르고 선명한 스캔에서 가장 잘 됩니다. 흐릿한 휴대폰 사진에서 뽑은 숫자는 믿기 전에 꼭 확인하세요.
거래내역서 여러 개를 한 번에 변환하기
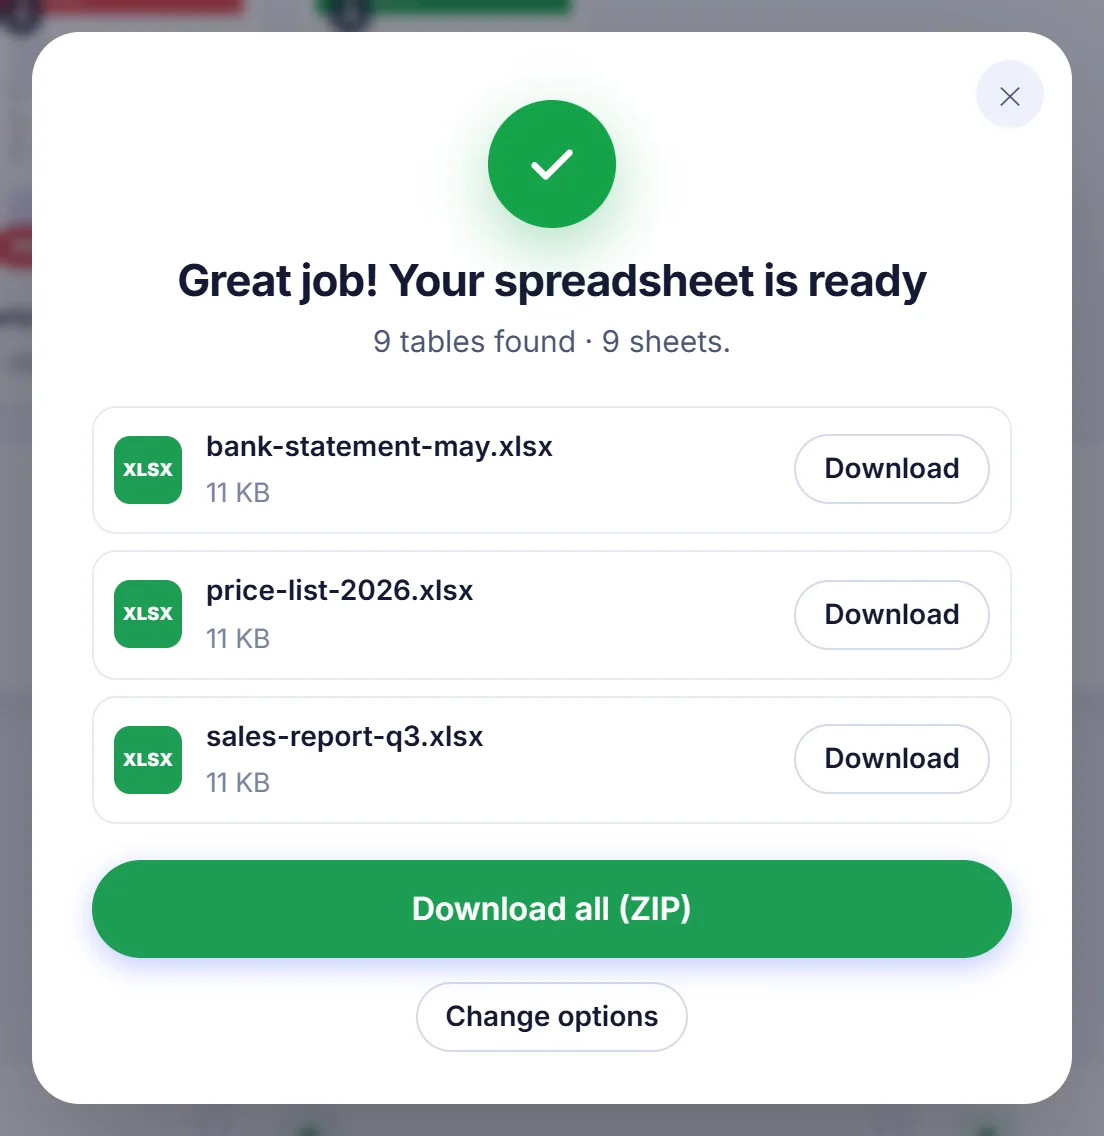
PDF 여러 개를 함께 추가하면 각각이 원본 파일 이름을 딴 별도의 통합 문서가 됩니다(예: march-statement.xlsx). 입력한 페이지 범위는 모든 파일에 적용되지만, 미리보기에는 첫 번째 파일만 표시됩니다. 파일이 둘 이상 만들어지면 ZIP 하나로 모두 받을 수 있습니다. CSV로 출력하면 시트가 여러 개인 통합 문서는 시트마다 하나씩 여러 CSV 파일로 나뉩니다.
자주 생기는 문제 해결하기
두 열이 하나로 합쳐졌습니다. PDF에서 두 열이 거의 붙어 있을 때 생기는 현상입니다. 변환 후 Excel의 텍스트 나누기 기능으로 열을 분리하세요.
줄바꿈된 줄이 별도의 행이 되었습니다. 고급 설정에서 줄바꿈된 셀 합치기 옵션이 켜져 있는지 확인하세요. 반대로 너무 많이 합쳐진다면 꺼 주세요.
휴대폰에서 중간에 멈춥니다. 큰 PDF는 메모리가 많이 필요한데 휴대폰은 메모리가 적습니다. 페이지 범위를 좁혀 조금씩 변환하거나 노트북을 사용하세요.
비밀번호 창이 계속 다시 뜹니다. 비밀번호가 틀렸다는 뜻입니다. 비밀번호를 받은 적이 없다면 문서를 보낸 사람에게 문의하세요.
데이터는 내 손안에 그대로
금융 거래내역서와 급여 보고서는 낯선 사람에게 넘겨서는 안 되는 바로 그런 종류의 파일입니다. 이 사이트에서는 브라우저 탭 안에서 실행되는 코드가 PDF를 열고 분석해 스프레드시트로 바꿉니다. 업로드 단계도 없고 서버에 남아 있는 사본도 없습니다. 탭을 닫으면 파일은 메모리에서 사라집니다.
자주 묻는 질문
PDF를 엑셀로 무료로 변환하려면 어떻게 하나요?
여기에 PDF를 추가하고 미리보기에서 표를 확인한 뒤 시트 배치를 고르고 변환 버튼을 누르세요. 계정을 만들 필요가 없고 파일에 워터마크도 붙지 않습니다.
PDF의 숫자가 수식에서도 그대로 동작하나요?
네. 금액, 통화, 백분율, 날짜는 숫자 서식이 적용된 실제 값으로 기록되므로 SUM, 정렬, 필터가 모두 작동합니다. 이 기능을 끄고 모든 셀을 일반 텍스트로 남길 수도 있습니다.
스캔한 PDF나 사진으로 찍은 표도 되나요?
네. 텍스트 레이어가 없는 페이지는 브라우저 안에서 OCR로 읽습니다. 먼저 문서 언어를 선택하세요. 언어 데이터는 처음 사용할 때 한 번만 다운로드됩니다.
PDF의 모든 페이지를 워크시트 하나로 합치려면 어떻게 하나요?
“All in one sheet” 배치를 선택하세요. 페이지가 순서대로 쌓이고, 첫 번째 표 머리글과 정확히 똑같은 반복 머리글은 제거됩니다.
비밀번호로 보호된 PDF도 엑셀로 변환할 수 있나요?
비밀번호를 알고 있다면 가능합니다. 파일을 열 때 비밀번호를 묻고, 그 비밀번호는 기기 밖으로 절대 나가지 않습니다.
결과를 XLSX 대신 CSV로 저장할 수 있나요?
네. “Save as” 메뉴에서 CSV를 선택하면 시트마다 CSV 파일 하나가 만들어지고, LibreOffice용으로는 ODS를 선택할 수 있습니다.